No es una sorpresa conocer lo importante que es la arquitectura Zen para AMD. La arquitectura, lanzada por primera vez en 2017, barrió todos los errores pasados de la compañía y junto con los chiplets, Infinity Fabric y 3D V-cache, allanó el camino hacia la rentabilidad y un rendimiento líder en el mercado. Desde entonces, ha habido algunos avances importantes en el diseño del chip, pero con el recién anunciado Zen 5 en Computex 2024, AMD presentará cambios con el fin de brindar notables aumentos de rendimiento en las aplicaciones adecuadas.
Comencemos con lo que no ha cambiado. Zen 5 es fundamentalmente igual que Zen 4, con los CCDs (Núcleos Complejos) que comprenden hasta ocho núcleos, compartiendo 32MB de caché L3. El IOD (Núcleo de Entrada/Salida) es prácticamente el mismo. Por lo tanto, no obtendrás más núcleos, hilos o caché en Zen 5 en comparación con Zen 4. En ese sentido, dado lo bien implementada que estuvo la arquitectura anterior, no existieron muchos motivos para implementar cambios drásticos.
Lo nuevo, sin embargo, radica profundamente dentro de las estructuras centrales mismas y principalmente se trata de llevar más datos a donde necesitan estar, mientras se mejora la eficiencia general de la capacidad de cálculo de un CCD.
La unidad de predicción de bifurcación de cada núcleo ha sido ajustada para hacerla más precisa y arrojar resultados de manera más rápida. Este circuito es responsable de determinar qué instrucciones es más probable que sigan en la cola para que un núcleo las procese, y el resto del núcleo luego busca los datos e instrucciones necesarios en cachés basadas en lo que el predictor calcula.
Así que un predictor de bifurcación más preciso y que responde más rápido significa que la eficiencia general del lado de procesamiento del chip es mejor, así que no hay nada de qué quejarse o criticar allí.
Zen 5 también presenta «tuberías y vectores más anchos», pero sin saber exactamente a qué se refiere AMD aquí, es difícil identificar qué ha cambiado precisamente en comparación con Zen 4. Tradicionalmente, una tubería más ancha significa que la secuencia de unidades lógicas que procesan instrucciones pueden manejar formatos de datos más grandes, pero en este caso, probablemente AMD se refiere a que la arquitectura Zen 5 tiene más tuberías, más programadores de instrucciones y la capacidad de despachar más instrucciones por ciclo en cada núcleo.
Esto concuerda con la afirmación de que Zen 5 también tiene un «tamaño de ventana más profundo», que casi con certeza se refiere al buffer de reordenamiento (ROB). Este es un componente de hardware que se encuentra entre la parte frontal del núcleo (responsable de decodificar instrucciones, renombrarlas, despachar microoperaciones, etc.) y la etapa de ejecución, que contiene los pipelines.
El trabajo del buffer de reordenamiento es mantener un seguimiento de las instrucciones que actualmente se están procesando en los pipelines hasta que se completen. AMD ha aumentado el tamaño del ROB a lo largo de las generaciones sucesivas de Zen, por lo que no sorprende verlo más grande en Zen 5. Los ROB más grandes ayudan a prevenir que los pipelines queden inactivos, así que sin esta mejora, el cambio de ‘tuberías más anchas’ no sería tan efectivo. Todo esto es una buena noticia para el rendimiento.
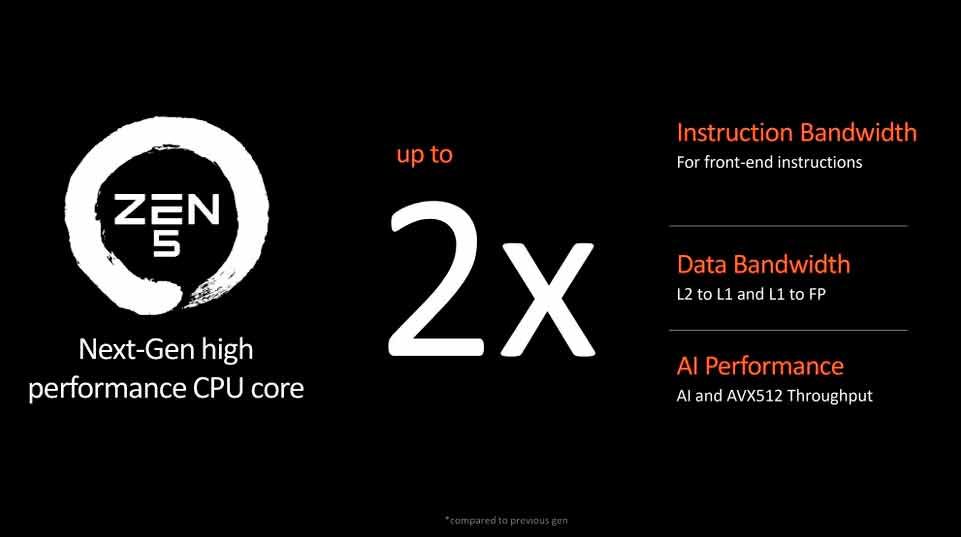
Las otras declaraciones de AMD destacan que Zen 5 tiene hasta dos veces más ancho de banda de instrucciones en la parte frontal y el mismo aumento entre la caché de datos L1 y los pipelines de punto flotante (también conocidos como vectores), así como entre las cachés L2 y L1.
De todos modos, para los profesionales que realizan creación de contenido seria, rutinas de IA y otras tareas que involucran operaciones vectoriales mega pesadas, hasta dos veces más «rendimiento de IA y AVX-512» será especialmente bienvenido. Zen 4 fue la primera arquitectura de AMD en admitir la extensión AVX-512, por lo que se esperaban mejoras aquí, pero si la velocidad de tales operaciones se ha duplicado, entonces Zen 5 será muy buscado en el mercado profesional.
El anuncio de Zen 5 de AMD parece bastante discreto, con solo dos diapositivas sobre los cambios en el núcleo, y no se ha dicho nada en absoluto sobre el núcleo de entrada/salida. Eso deja asumir que no ha cambiado, pero dado que la serie Ryzen 9000 en una placa base X870 admite velocidades de RAM más altas que la serie 7000 en una placa base X670, algo debe haber sido actualizado.
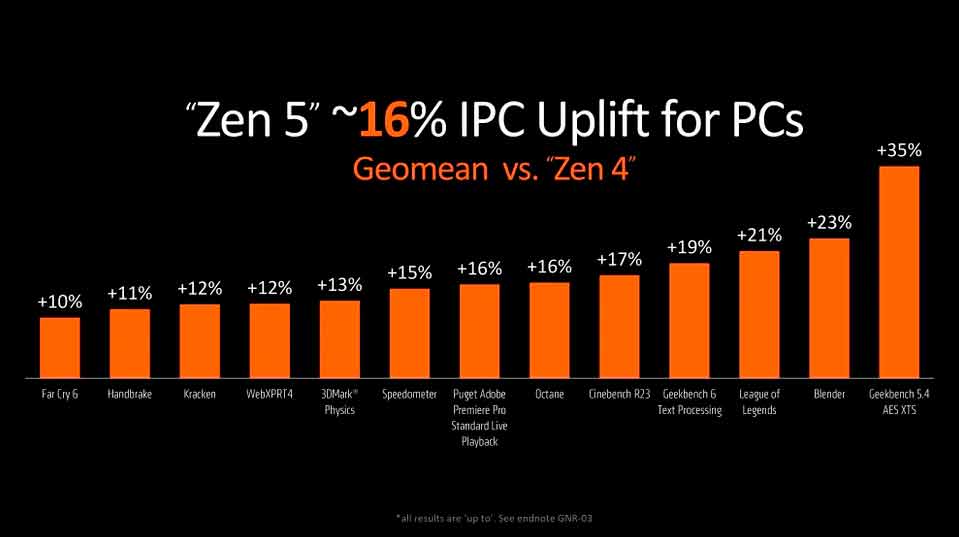
Más importante aún, cuando obtienes hasta un 23% más de rendimiento en Blender en comparación con Zen 4 a la misma velocidad de reloj, está claro que las mejoras son muy significativas. Los juegos son mucho menos sensibles a los aumentos de IPC (instrucciones por ciclo), ya que dependen más de la caché y la memoria, pero aún así, un 21% más de fotogramas por segundo en League of Legends, e incluso un 10% en Far Cry 6, no deben ser desestimados ligeramente.